

Supermicro hợp tác IBM và NVIDIA phát triển giải pháp KV Cache, tăng tốc suy luận AI lên tới 56 lần
Supermicro, IBM và NVIDIA vừa công bố giải pháp lưu trữ KV Cache tích hợp, kết hợp máy chủ lưu trữ Petascale, phần mềm IBM Storage Scale, nền tảng suy luận NVIDIA Dynamo và hạ tầng mạng Spectrum-X Ethernet. Giải pháp hướng đến giải quyết áp lực bộ nhớ trong các tác vụ AI Inference, cải thiện khả năng khai thác GPU và mở rộng hạ tầng AI doanh nghiệp.
Ngày 05/11/2026, Super Micro Computer, Inc. (Supermicro) công bố hợp tác với IBM và NVIDIA phát triển giải pháp lưu trữ KV Cache dành cho các hệ thống suy luận AI quy mô lớn. Sự kết hợp giữa máy chủ, phần mềm lưu trữ, nền tảng suy luận và mạng tốc độ cao tạo ra một kiến trúc lưu trữ dùng chung, cho phép mở rộng dung lượng KV Cache vượt ra ngoài giới hạn bộ nhớ GPU cục bộ.
Theo kết quả thử nghiệm do Supermicro và NVIDIA công bố, giải pháp đạt mức cải thiện thời gian tạo token đầu tiên (Time-to-First-Token – TTFT) lên tới 56 lần so với hệ thống không sử dụng KV Cache trong một kịch bản thử nghiệm với mô hình ngôn ngữ lớn 120 tỷ tham số.
Giải pháp KV Cache kết hợp công nghệ từ Supermicro, IBM và NVIDIA
Kiến trúc mới được xây dựng trên sự kết hợp của bốn thành phần công nghệ chính:
-
Supermicro Petascale: Hệ thống máy chủ lưu trữ all-flash sử dụng bộ xử lý AMD EPYC 9005 Series (tên mã Turin), cung cấp năng lực lưu trữ dung lượng lớn và hiệu năng cao.
-
IBM Storage Scale: Phần mềm quản lý lưu trữ, cung cấp lớp lưu trữ dùng chung cho dữ liệu KV Cache giữa các nút GPU và cụm hệ thống.
-
NVIDIA Dynamo: Nền tảng phần mềm hỗ trợ điều phối suy luận AI phân tán và tối ưu việc quản lý, tái sử dụng KV Cache.
-
NVIDIA Spectrum-X Ethernet: Hạ tầng mạng Ethernet hiệu năng cao, hỗ trợ kết nối và trao đổi dữ liệu giữa các thành phần trong kiến trúc.
Thay vì giới hạn KV Cache trong bộ nhớ GPU cục bộ, giải pháp đưa dữ liệu này sang một tầng lưu trữ mạng dùng chung. Cách tiếp cận này giúp hệ thống mở rộng dung lượng KV Cache độc lập hơn với tài nguyên GPU, đồng thời hỗ trợ chia sẻ dữ liệu giữa nhiều nút xử lý.
KV Cache giải quyết áp lực bộ nhớ trong AI Inference như thế nào?
Trong quá trình suy luận của mô hình ngôn ngữ lớn (LLM), hệ thống thường trải qua hai giai đoạn chính là Prefill và Decode.
Ở giai đoạn Prefill, dữ liệu đầu vào được chuyển thành các token và xử lý để tạo ra những trạng thái Key-Value (KV) trung gian. Đây là dữ liệu cần thiết để mô hình tiếp tục tạo phản hồi trong giai đoạn Decode.
KV Cache có nhiệm vụ lưu trữ những trạng thái KV đã được tính toán, cho phép hệ thống tái sử dụng chúng khi xử lý các yêu cầu tiếp theo thay vì phải tính toán lại cùng một ngữ cảnh. Điều này đặc biệt hữu ích đối với những ứng dụng có lượng dữ liệu đầu vào lớn hoặc cần duy trì ngữ cảnh qua nhiều lượt tương tác.
Các tác vụ như Agentic AI, trợ lý lập trình, RAG xử lý tài liệu dài, AI đa phương thức và hội thoại nhiều lượt có thể tạo ra lượng dữ liệu KV Cache rất lớn. Khi dung lượng này vượt quá khả năng đáp ứng của bộ nhớ GPU và CPU, hệ thống cần một phương thức lưu trữ và truy xuất dữ liệu hiệu quả hơn.
Giải pháp của Supermicro, IBM và NVIDIA giải quyết vấn đề bằng cách mở rộng KV Cache sang hệ thống lưu trữ mạng dung lượng lớn. Nhờ đó, dữ liệu ngữ cảnh có thể được duy trì và chia sẻ giữa các nút GPU, giảm nhu cầu tính toán lặp lại và hạn chế tình trạng GPU phải chờ dữ liệu.
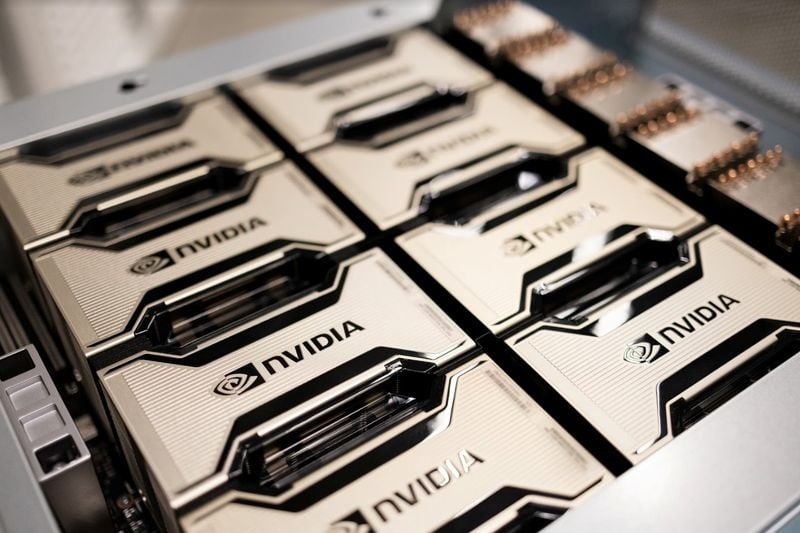
Thử nghiệm ghi nhận TTFT nhanh hơn tới 56 lần
Một trong những kết quả đáng chú ý nhất của giải pháp là khả năng cải thiện thời gian tạo token đầu tiên, yếu tố ảnh hưởng trực tiếp đến độ trễ phản hồi mà người dùng cảm nhận khi tương tác với AI.
Trong thử nghiệm phối hợp giữa Supermicro và NVIDIA với mô hình LLM có 120 tỷ tham số, giải pháp KV Cache lưu trữ lâu dài ghi nhận:
-
TTFT nhanh hơn tới 56 lần tại mức đầu vào 130.000 token so với hệ thống không sử dụng KV Cache.
-
Khi độ dài đầu vào tăng từ 30.000 lên 130.000 token, TTFT chỉ tăng thêm 0,377 giây với KV Cache, trong khi hệ thống không sử dụng giải pháp này ghi nhận mức tăng 29,55 giây.
Kết quả cho thấy việc lưu trữ và tái sử dụng trạng thái KV có thể giúp duy trì độ trễ phản hồi ổn định hơn khi xử lý các tác vụ có ngữ cảnh dài.
Ngoài cải thiện TTFT, giải pháp còn hướng đến nâng cao mức độ sử dụng GPU và thông lượng suy luận. Việc duy trì dữ liệu ngữ cảnh thường xuyên được sử dụng bên ngoài bộ nhớ GPU giúp giảm thời gian GPU nhàn rỗi, hỗ trợ xử lý đồng thời nhiều yêu cầu mà không phải tăng số lượng GPU theo cùng tỷ lệ.
Hướng đến hạ tầng AI có khả năng mở rộng và độ sẵn sàng cao
Bên cạnh hiệu năng, Supermicro, IBM và NVIDIA cũng nhấn mạnh khả năng phục hồi và tính sẵn sàng của hệ thống.
Nhờ sử dụng tầng lưu trữ KV Cache lâu dài và dùng chung, kiến trúc có thể hỗ trợ truy cập dữ liệu giữa nhiều nút GPU và cụm hệ thống. Điều này giúp doanh nghiệp quản lý trạng thái suy luận hiệu quả hơn, đồng thời mở rộng dung lượng lưu trữ mà không cần phụ thuộc hoàn toàn vào việc bổ sung tài nguyên tính toán.
Ba công ty cho biết đã thực hiện các thử nghiệm ở cấp độ cụm hệ thống, bao gồm những kịch bản có mức độ đồng thời cao và tình trạng lưu lượng mạng cạnh tranh tài nguyên giữa các tác vụ (noisy-neighbor), nhằm đánh giá hiệu năng của kiến trúc tích hợp trong các điều kiện vận hành khác nhau.
Supermicro cũng cung cấp dịch vụ tích hợp hệ thống tại nhà máy và triển khai trực tiếp tại địa điểm khách hàng. Theo công ty, các dịch vụ này có thể rút ngắn thời gian triển khai giải pháp từ vài tuần xuống còn vài ngày.
Lưu trữ trở thành một thành phần quan trọng trong kiến trúc AI Inference
Sự hợp tác giữa Supermicro, IBM và NVIDIA cho thấy xu hướng phát triển hạ tầng AI đang mở rộng từ việc tăng năng lực tính toán sang tối ưu toàn bộ hệ thống xử lý dữ liệu.
Khi các mô hình AI ngày càng lớn và ứng dụng Agentic AI đòi hỏi khả năng duy trì, truy xuất lượng lớn dữ liệu ngữ cảnh, bộ nhớ GPU không còn là tầng tài nguyên duy nhất cần được quan tâm. Hệ thống lưu trữ dung lượng lớn, phần mềm quản lý dữ liệu và mạng tốc độ cao cũng đóng vai trò quan trọng trong việc đảm bảo hiệu quả vận hành.
Với kiến trúc KV Cache mới, Supermicro, IBM và NVIDIA hướng đến giải quyết đồng thời bài toán dung lượng bộ nhớ, độ trễ phản hồi và khả năng mở rộng tài nguyên cho các hệ thống AI Inference. Đây là một hướng tiếp cận đáng chú ý đối với doanh nghiệp đang xây dựng hạ tầng phục vụ các ứng dụng AI có khối lượng công việc lớn và yêu cầu xử lý ngữ cảnh phức tạp.
Nguồn: Supermicro – Supermicro Launches KV Cache Solution with IBM and NVIDIA Demonstrating Significant Inference Performance Benefits, ngày 05/11/2026.
Chia sẻ bài viết


Bình luận
( 0 bình luận )Bình luận của bạn
Tin tức liên quan